 VitePress
Appearance
AI 私有知识库实践总结
问题背景
我一直想搭建一个问答型知识库,用于管理家庭的所有保单信息。这样在遇到不同情况时,就可以快速基于知识库做初步判断,比如:什么能保、什么不保、是否存在其他限制条件等。
方案
经过调研,我最终选择了 AnythingLLM 来完成这件事。
过程
在实际执行过程中,我发现知识库效果很大程度上取决于原始数据质量。当然,在开始之前我对此已经有一定预判,所以我设计的流程是:
source -> md -> anythingLLM
在我看来,数据质量的重要性甚至 大于后续技术方案本身。
这里顺便简单说一下 AnythingLLM 的检索流程:
提问 -> 问题向量化 -> 检索相似文档 -> 取回相关片段 -> 拼接上下文 -> 调用大模型 -> 返回答案
其中,文档切分质量会直接影响最终效果。
结论
基于向量库的 RAG,在这类场景下效果其实并不好。
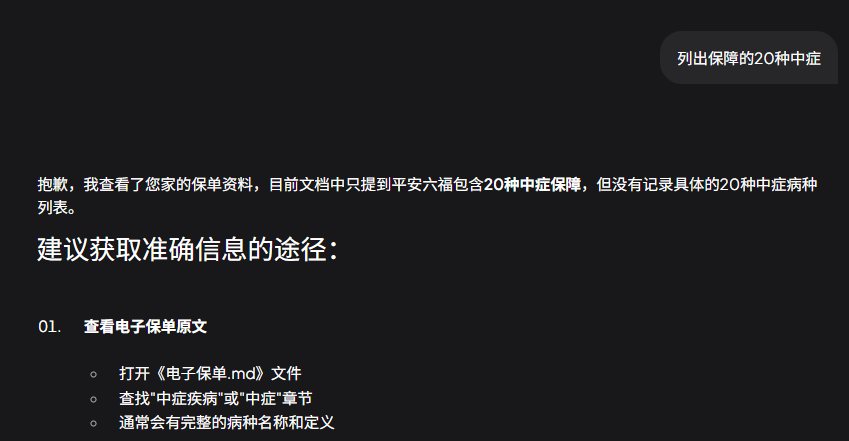
一开始没找到答案,后来我自己翻了翻,手动找到了。然后再问一次:
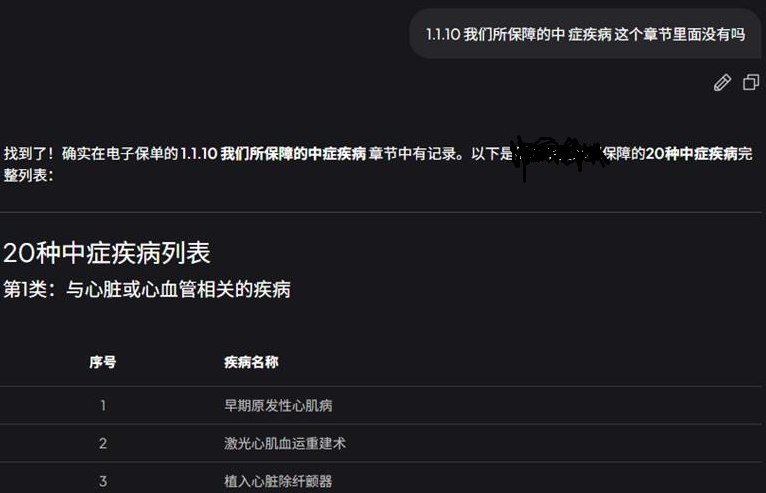
这次就找到了。
但问题在于,这种经验无法复制。我也尝试过通过提示词去约束检索策略,但效果并不理想。因为整个流程基本是固定的,如果要进一步优化,就需要直接改源码,而这件事对我来说太麻烦了。
当然,如果换成更好的切分模型和向量库,效果理论上应该会有所改善。但这里有一个更根本的问题:这套流程看起来并不真正理解语义。不管怎么切分,它始终还是“不懂内容到底是什么”。
所以后来我换了一个方向,直接基于通用 Agent 去做,结果一次就过了。而且可以预见的是,如果后续继续在结构上优化、持续记录和改进检索策略,效果应该会越来越好。
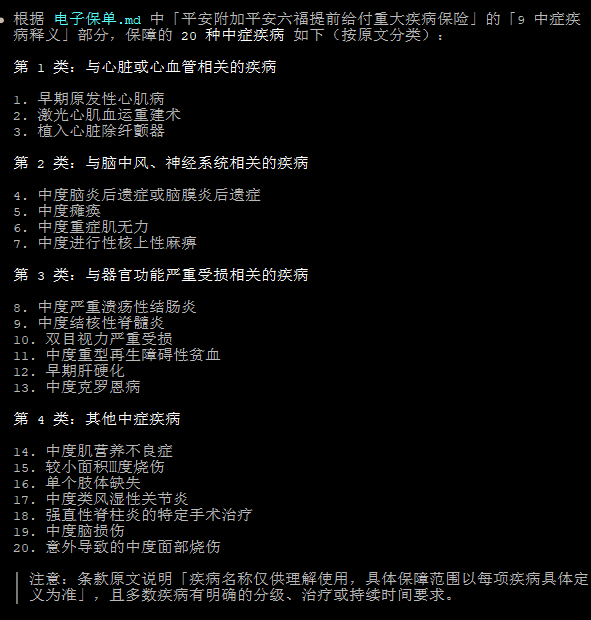
当然,这种方式的缺点也很明显:你自己至少得会玩 Agent,同时还得懂保单内容,知道该怎么优化检索策略。
不过,这次尝试也并非毫无收获。我后来把之前《金刚经》的解析内容导入进去,问了一个比较开放性的问题,效果其实非常不错。
这也说明,这类技术如果用于开放性问题、精度要求不高、且不需要太强专业能力的知识库场景,其实还是非常合适的。